
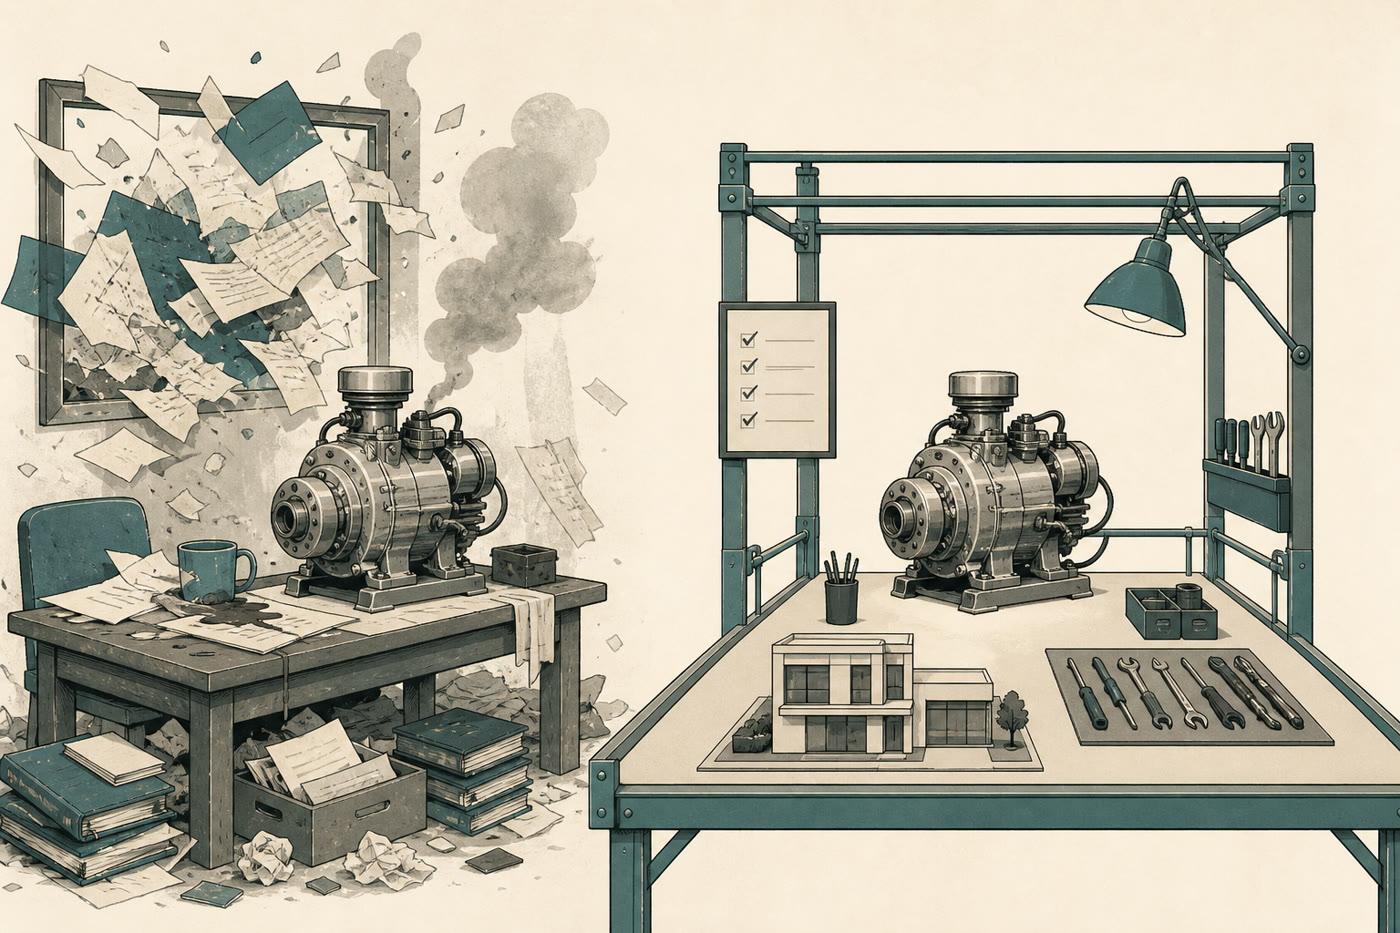
Kamu tidak salah pakai AI karena belum ketemu model yang tepat.
Kamu salah karena belum bangun lingkungannya.
Rohit menulis itu di X Article-nya. Bukan perang merk. Yang ditunjuk lebih tajam:
Model adalah mesin. Harness-nya — lingkungan lengkap tempat model itu berpikir — adalah semuanya.
Ada tim yang mengirim satu juta baris kode dengan tiga engineer. Ada yang susah dapat satu refactor yang konsisten dari pipeline agent-nya. Bedanya bukan GPT-5 versus Claude Opus.
Paper SWE-agent Princeton, SWE-bench Lite, GPT-4 Turbo yang sama: lewat shell biasa 11%. Lewat Agent-Computer Interface yang dirancang, 18%. Kenaikan relatif 64%. Hanya dari interface-nya.
Bukan temperature. Bukan max tokens. Bukan “prompt yang lebih pintar”, meski industri sudah menghabiskan tahun-tahun kolektif untuk berdebat soal itu.
Bedanya: harness.
Harness bukan system prompt
Kata ini dipakai longgar.
Harness bukan system prompt. Bukan wrapper di atas satu API call. Bukan chatbot yang “punya memori”.
Harness adalah lingkungan yang dirancang tempat model bahasa bekerja: tool yang bisa dipanggil, format informasi yang diterima, cara sejarahnya dikompres, pagar yang menangkap salahnya sebelum merambat, dan scaffolding yang membiarkannya menyerahkan kerja ke dirinya di sesi berikutnya tanpa kehilangan koherensi.
Mesinnya yang berpikir. Harness-nya yang menentukan apa yang dipikirkan.
Itu kenapa dua orang bisa pakai model yang sama lalu satu merasa ajaib, satu merasa payah. Keduanya benar. Tidak ada yang paham kenapa — sampai kamu berhenti melihat otaknya, dan mulai melihat tubuhnya.
Context window bukan RAM
Model naif: context window itu RAM. Masukkan data, model proses, keluar hasil. Lebih banyak konteks = lebih pintar.
Salah. Dan kalau kamu bangun agent di atas model itu, agent-mu akan rusak.
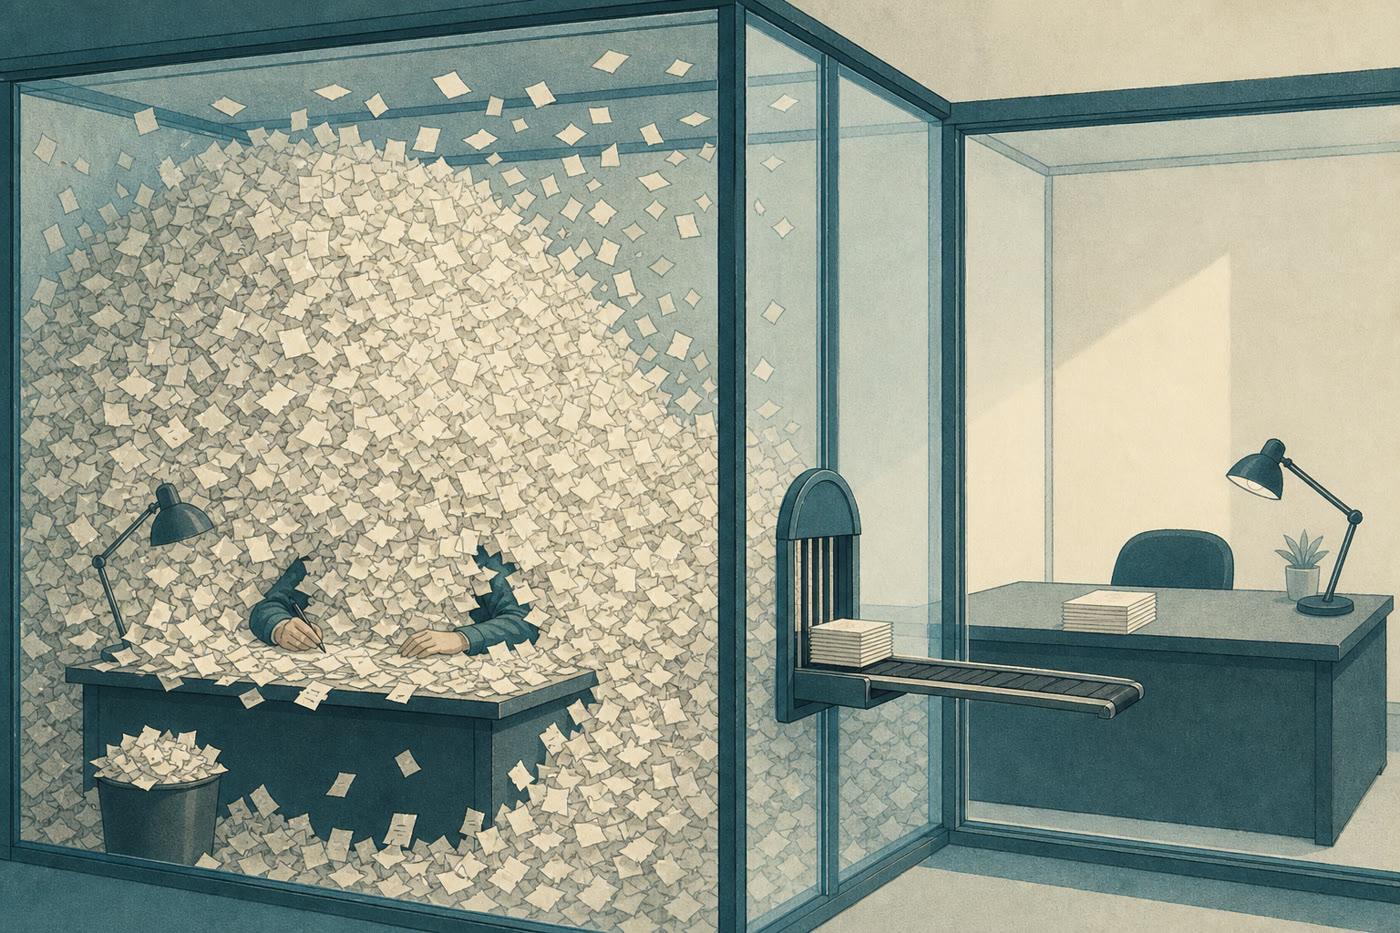
Context window lebih dekat ke seluruh kesadaran kerja agent untuk satu sesi. Setiap token memakan komputasi. Setiap informasi yang tidak relevan bersaing untuk perhatian dengan yang relevan. Model tidak punya mekanisme perhatian selektif yang rapi mengabaikan noise. Noise-nya ada di ruangan. Dan ia memengaruhi nalar.
Grep satu codebase besar, kembalikan sepuluh ribu baris match: kamu tidak memberi agent lebih banyak informasi. Kamu membanjiri working memory-nya. Kualitas setiap langkah berikutnya turun sampai context dibersihkan. Dump seluruh file karena agent ingin lihat dua fungsi: kamu kasih selang pemadam saat yang dibutuhkan gelas minum.
Peneliti SWE-agent mendokumentasikan ini dengan teliti. Interface bash standar membuat agent thrash. Grep, kebanjiran, lupa sedang mencari apa, grep lagi, context penuh noise, lalu salah jawab atau berhenti sama sekali. Bukan karena modelnya bodoh. Karena interface-nya tidak punya cara melindungi agent dari dirinya sendiri.
Solusinya hampir menghina kesederhanaannya: search tool yang maksimal 50 hasil. Kalau lebih, output ditahan, agent disuruh mempersempit query. Satu keputusan desain. Salah satu yang paling leverage di seluruh paper.
Kamu tidak boleh kabur dengan menjadi samar. Kamu harus spesifik. Tool-nya memaksa perilaku yang lebih baik.
Untuk agent, interface bukan lapisan kenyamanan.
Interface adalah pikirannya.
Yang gagal di batas jendela
SWE-agent mengurus satu sesi. Anthropic, waktu membangun Claude Code, ketemu masalah lain: bagaimana kalau tugasnya terlalu besar untuk satu context window?
Kebanyakan proyek perangkat lunak nyata tidak muat di jendela mana pun. Engineer manusia menyelesaikannya dengan memori eksternal, dokumentasi, version control, pemahaman yang menumpuk berminggu-minggu. Agent yang buka sesi baru tidak punya itu.
Compaction — merangkum context lama — tidak cukup.
Temuan Anthropic: bahkan model frontier seperti Opus 4.5 yang di-loop lewat banyak jendela, dengan compaction, tetap gagal membangun web app produksi dari prompt tingkat tinggi.
Dua pola.
Pertama: mencoba semuanya sekaligus. “Bangun klon claude.ai.” Agent mulai fitur demi fitur tanpa menyelesaikan atau mengetes satu pun, kehabisan context di tengah, meninggalkan sesi berikutnya dengan setengah implementasi, tanpa catatan, tanpa tahu state kodenya.
Kedua: kemenangan prematur. Sesi berikutnya melihat ada progres, lalu menyimpulkan pekerjaan selesai. Menyatakan menang di aplikasi yang masih bolong. Bukan kebodohan. Inferensi yang wajar dari informasi yang tidak lengkap. Agent tidak punya cara terstruktur untuk tahu apa artinya “selesai”.
Akar yang sama: tidak ada pemahaman persisten soal state proyek yang selamat melewati batas jendela.
Solusinya arsitektur dua agent. Initializer sekali: tidak menulis fitur. Ia membangun scaffolding untuk semua sesi berikutnya — script boot, daftar fitur sebagai perilaku pengguna end-to-end (bukan “tombol X ada”), file progres, commit pertama. Coding agent di setiap sesi berikutnya: satu fitur, tinggalkan lingkungan bersih, update progres dan git sebelum sesi tutup.
Daftar fitur disimpan JSON, bukan Markdown. Alasan perilaku: model lebih jarang menimpa JSON secara ugal-ugalan. Completeness jadi eksplisit. passes: true atau false. Tidak ada yang harus disimpulkan dari kode.
Kalau agent tidak bisa mengamati konsekuensi aksinya di domain yang penting, ia akan mengoptimalkan proxy yang tidak nyambung dengan benar. Unit test hijau, di browser rusak. Anthropic menutup loop itu dengan otomasi browser. Kualitas kerja agent dibatasi kualitas feedback loop-nya.
Bottleneck-nya tidak pernah kecerdasan model
Tim Codex OpenAI memulai repositori dengan satu constraint: tidak ada kode yang ditulis tangan. Lima bulan. Sekitar satu juta baris. 1.500 PR. Tiga engineer, rata-rata 3,5 PR per orang per hari. Saat tim jadi tujuh, throughput per orang naik.
Ryan Lopopolo: bottleneck-nya tidak pernah kemampuan model. Selalu desain lingkungan.
Pekerjaan engineer berubah. Kamu tidak lagi nulis kode. Kamu merancang lingkungan. Menspesifikasi niat. Membangun feedback loop. Bukan “bagaimana saya perbaiki bug ini?” tapi “kapabilitas apa yang hilang dari lingkungan, sampai kelas bug ini muncul?”
Ketika sesuatu gagal, perbaikannya hampir tidak pernah “coba lebih keras”. Hampir selalu “potongan struktural apa yang belum ada?”
Mereka mencoba satu file instruksi raksasa. Gagal dengan empat cara yang bisa ditebak: crowding, semua ditandai penting jadi tidak ada yang penting, cepat busuk, tidak bisa diverifikasi. Solusinya docs/ sebagai sistem catatan, AGENTS.md dipotong jadi sekitar 100 baris — daftar isi, bukan ensiklopedia. Disclosure bertahap. Titik masuk kecil yang stabil, lalu diajari ke mana harus melihat.
Saat throughput meledak, bottleneck pindah ke verifikasi. Solusinya: buat aplikasinya terlihat oleh agent. Boot per worktree. Browser. Log. Trace. Linter kustom yang menolak pelanggaran arsitektur dan mengembalikan instruksi perbaikan yang bisa disuntik ke context. Review manusia tidak scale ke 3,5 PR per engineer per hari. Yang scale: penegakan mekanis atas invarians, bukan implementasi.
Koreksi murah. Menunggu mahal. Tradeoff yang kelihatan tidak bertanggung jawab di lingkungan throughput rendah, dan kelihatan jelas di yang tinggi.
Lima pola yang terus muncul
Princeton, Anthropic, OpenAI, Stripe, Perplexity. Bukan kebetulan. Solusi untuk masalah yang muncul setiap kali agent di-deploy pada skala.
- Disclosure bertahap. Jangan kasih semua di depan. Minimum untuk orientasi, pointer untuk sisanya. Context terbatas, perhatian tidak merata. Titik masuk pendek lebih akurat — dokumen monolit cepat busuk.
- Isolasi per agent. Satu agent, satu workspace. Worktree paling minim. VM di skala Stripe.
- Repositori sebagai sistem catatan. Agent buta terhadap pengetahuan informal. Slack, Google Doc, kepala seseorang: tidak ada. Spesifikasi yang ambigu, basi, atau di luar repo secara aktif merusak kinerja.
- Penegakan mekanis, bukan review manusia. Tegakkan invarians, bukan implementasi. Arah dependensi. Validasi di batas. Jangan mendikte library mana.
- Feedback loop ketat. Syntax error saat edit. Bug UI lewat browser. Kegagalan tes dikembalikan dengan konteks. Jarak antara aksi dan konsekuensi, setiap kali bisa dipendekkan, adalah tempat performa naik.
Yang perlu ditanya, kalau agent-mu payah
Bukan “bagaimana tulis prompt yang lebih baik?”
Apa informasi yang dibutuhkan agent dan sekarang tidak bisa diakses?
Feedback loop mana yang hilang, yang seharusnya menangkap salah ini sebelum merambat?
Constraint apa di lingkungan yang mencegah perilaku yang benar?
Prompt yang lebih baik untuk kegagalan spesifik itu lokal dan sementara. Tool yang mencegah satu kategori kegagalan itu umum dan permanen. Harness adalah tempat investasi permanen tinggal.
Implikasinya tidak nyaman, dan perlu dikatakan lurus.
Kalau lapisan eksekusi jadi komoditas, parit jangka panjang bukan di model. Di harness.
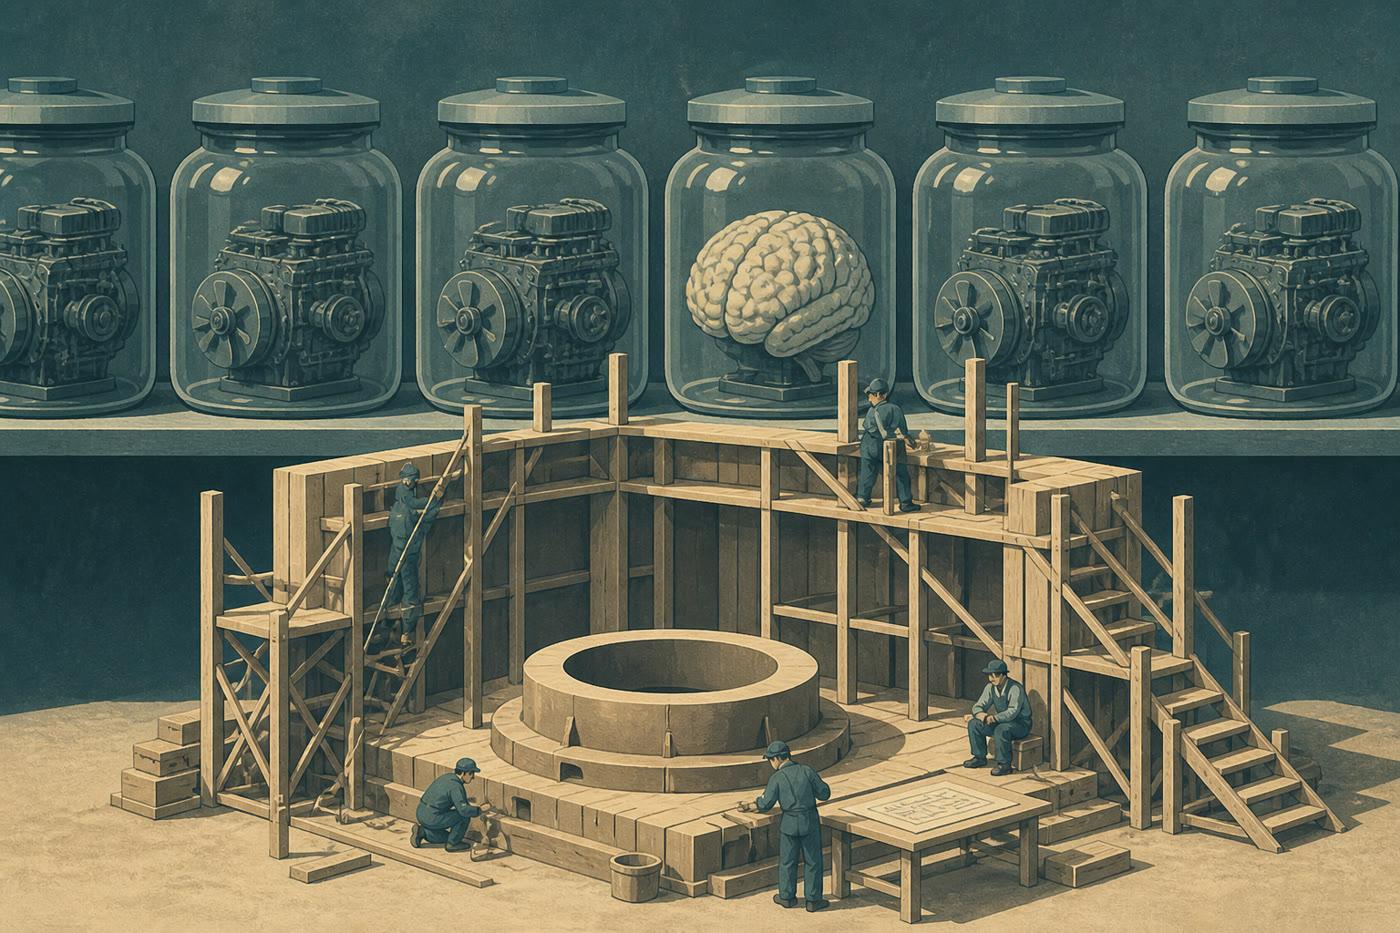
Organisasi yang investasi di scaffolding, feedback, observability, spec, orkestrasi — yang membuat agent kerja andal pada skala — punya keunggulan yang tahan lama dibanding yang sibuk memilih model mana atau cara prompt apa.
Pola lama: yang menarik perhatian publik — skor, benchmark, “siapa yang lebih pintar” — jarang yang menentukan siapa yang menang. Infrastruktur yang menata kapabilitas itu: di situlah nilai yang tahan lama dibuat.
Web bukan transformasi karena HTML ada. Karena search engine dan browser membuatnya bisa dinavigasi. Mobile bukan karena smartphone ada. Karena app store dan tool developer membuatnya bisa dibangun pada skala.
Agent mengikuti pola yang sama. Kapabilitasnya sudah ada. Yang tertinggal: artefak yang bisa di-deploy.
Model yang berpikir. Harness yang ia pikirkan.
Membedakan itu dengan benar adalah seluruh permainannya.
Sumber: The Harness Is Everything: What Cursor, Claude Code, and Perplexity Actually Built — Rohit (@rohit4verse).